

作者: 新智元
就在刚刚,Karpathy抛出一个冷酷真相:人类对AI能力的认知,正在经历一场惊人的「认知折叠」。
圈内人天天高呼AGI即将到来,大众却对此嗤之以鼻。
为什么?Karpathy揭开真相:全球约75%的人口根本没碰过大模型,而最顶层掌握前沿系统的人仅有区区5000人。
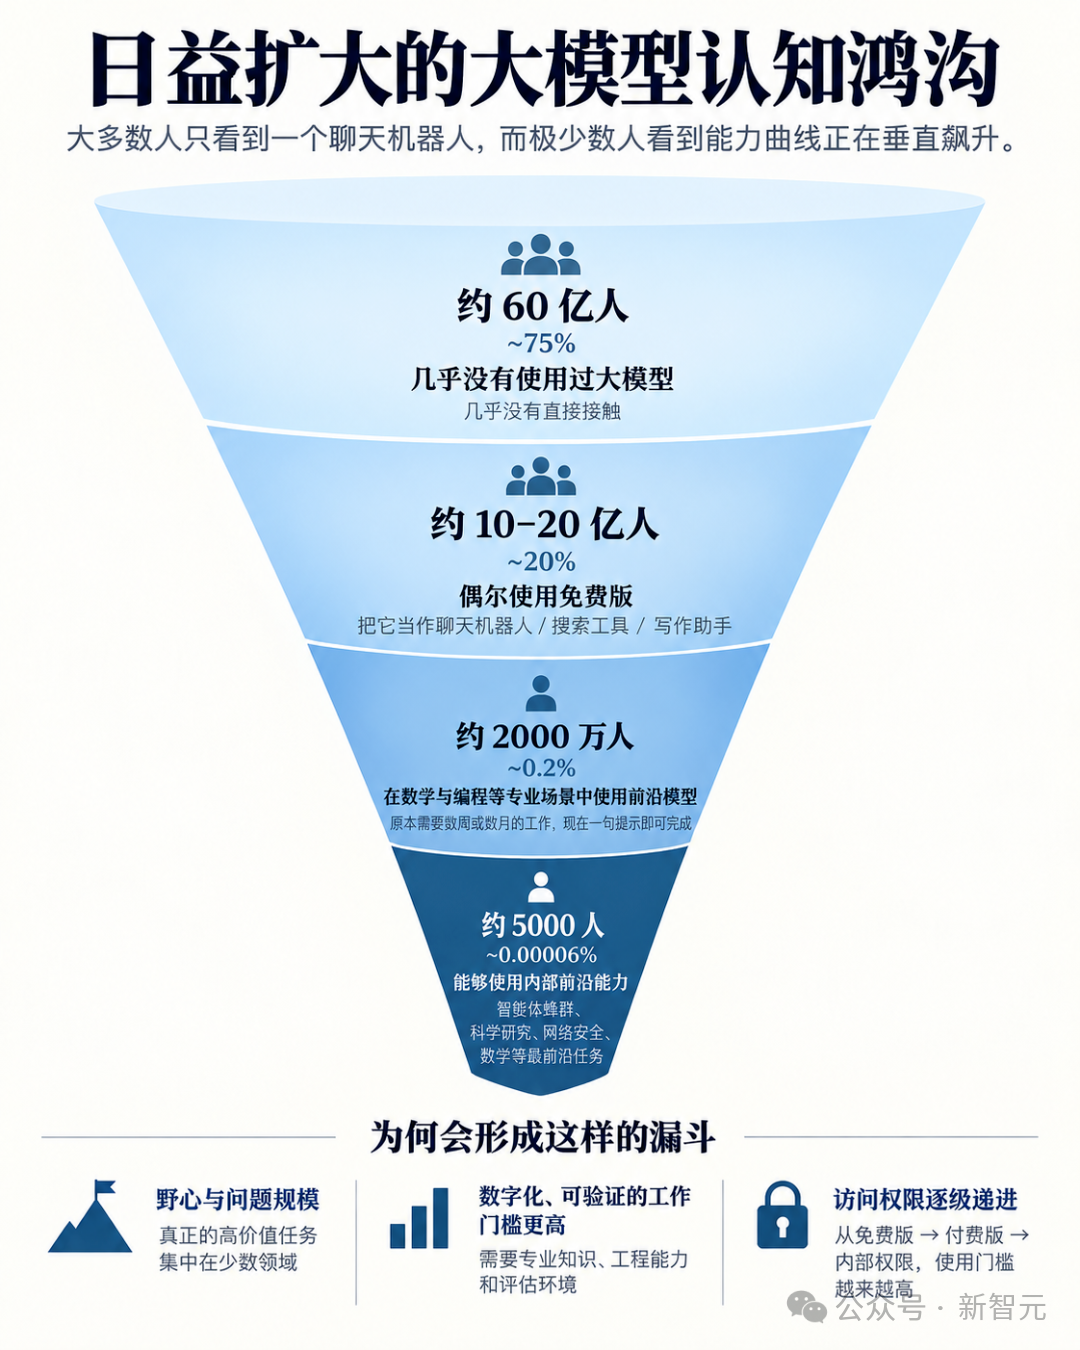
这是一个陡峭的「四级认知漏斗」。
当几十亿人还在嘲笑免费版AI连简单问题都答错时,全球顶级的2000万人正陷入「智能体眩晕」。
而在最TOP 5000人的禁区,数千个「智能体蜂群」正在自主协作、攻防零日漏洞、推演前沿数学,把人类远远甩在后面。
大众看到的AI,与实验室前沿的真正实力,已经隔了一道鸿沟。
第一重折叠:60亿人的无视与20亿人的「错觉」
AI已经普及到了每一个角落了?
Karpathy的「餐巾纸估算」结果惊人。在这个陡峭的漏斗模型中,绝大多数人被无情地挡在了门外。
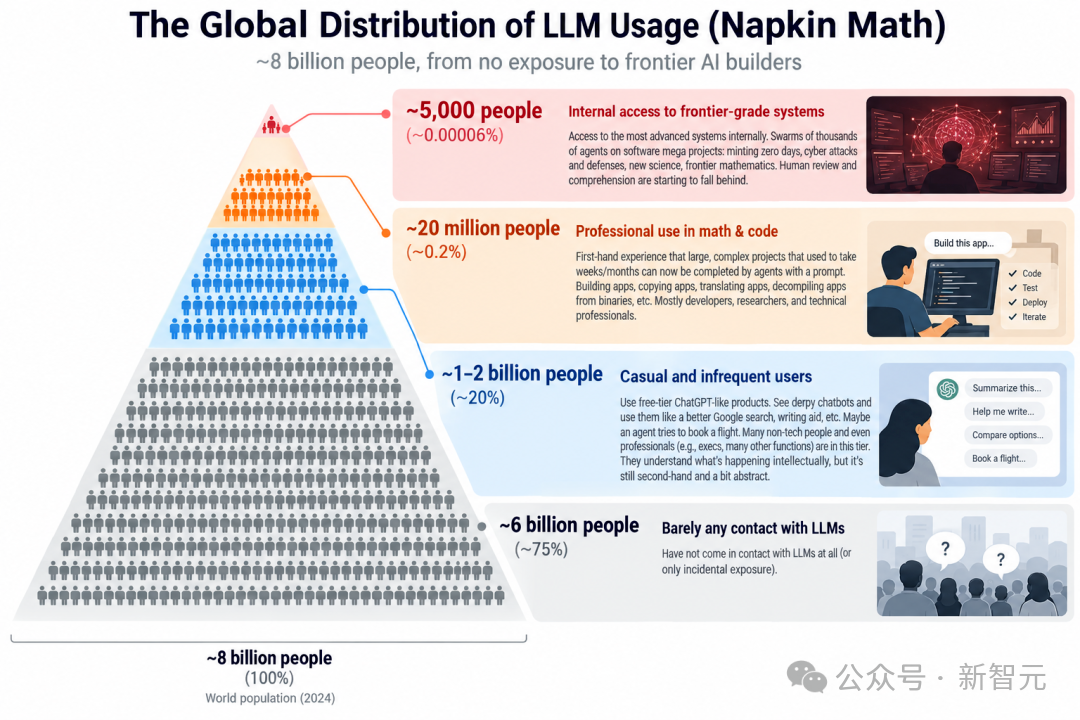
漏斗最底层:60亿人的「AI真空区」(占全球人口约75%)
在这个世界上,有大约60亿人,至今几乎完全没有接触过任何LLM。对于他们而言,AI只存在于新闻标题和科幻电影中。
这场被硅谷誉为第四次工业革命的浪潮,根本没有进入这75%的人类生活。
漏斗第二层:10到20亿人的「笨拙助手错觉」(占全球人口约20%)
在这个层级中,大约有10到20亿人,他们是免费版、类似ChatGPT产品的偶尔使用者。
在他们眼中,AI只是一个「笨拙的聊天机器人」。
人们把它当作一个更好用的Google搜索,或者一个写作辅助工具,顶多是一个试图帮你预订航班的初级智能体。
Karpathy坦言,他有很多非技术圈的朋友表示,他们觉得这东西在日常生活中根本没太大用处。
甚至,许多非数学和代码领域的专业人士,包括许多企业高管,也仅仅停留在这个层级。高管们每天把大量时间花在与人沟通上,虽然他们在理智上「知道」AI正在发生什么,但这种认知是二手的、极其抽象的。
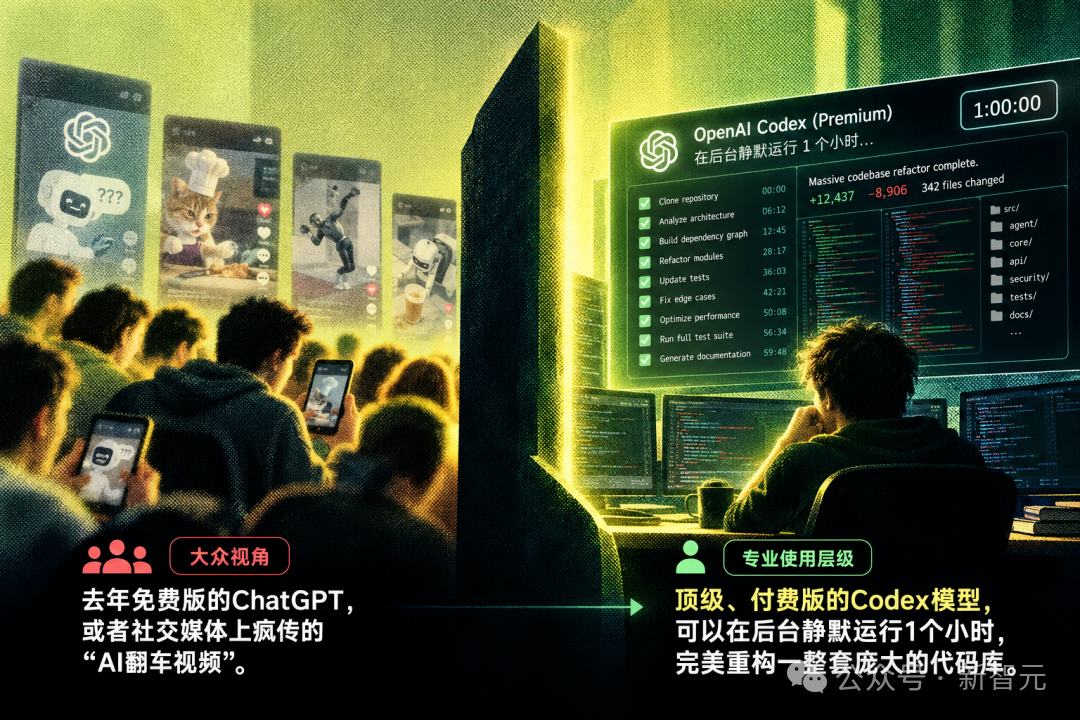
这就引出了一个致命的「近因效应与使用层级」问题。很多人的AI世界观,是被去年免费版的ChatGPT,或者是那些在社交媒体上疯传的「AI翻车视频」塑造的。
比如,很多人都看过OpenAI高级语音模式在面对「我应该开车还是步行去洗车」这种简单问题时结结巴巴、不知所云的搞笑视频。
大众在Instagram的短视频里看着AI产生幻觉、说胡话,然后哈哈大笑,心想:「就这?这就是你们说的超级智能?」
但Karpathy警告:大众完全被免费版和旧模型骗了。
那些被废弃的旧模型,根本无法代表今年最新一代前沿智能体(尤其是OpenAI Codex和Claude Code)的真正实力。
第二重折叠:2000万专业人士的「智能体眩晕」
当我们来到漏斗的第三层,画风突变。这里的空气开始变得稀薄,只有大约 2000万人(占全球人口0.2%) 。
在这个由数学和编程专业人士组成的群体中,一种被称为「AI精神病」和「智能体眩晕」的集体症状正在蔓延。
为什么?因为他们正在亲眼目睹一场陡峭进化。
在这一层,人们付费使用最前沿的智能体模型(Codex / Claude Code),并且将其应用于编程、数学和研究等迎合领域。
Karpathy用他自己的亲身经历现身说法:「这一切发生得太快了,就在不到一年前,我还在纯手工写代码,把烂熟于心的计算机命令一个字符一个字符地敲进编辑器里,偶尔按一下Tab键让它自动补全一小段。」
但现在呢?一切都被颠覆了。
那些曾经需要顶级工程师数月的大型的项目,现在只需要一个提示词,前沿智能体就能在极短的时间内完成,包括构建应用、复制应用、翻译应用、从二进制文件中反编译应用……
当你把一个计算机终端交给这些模型,你可以亲眼看着它们「熔化」那些要耗费几周的编程难题。
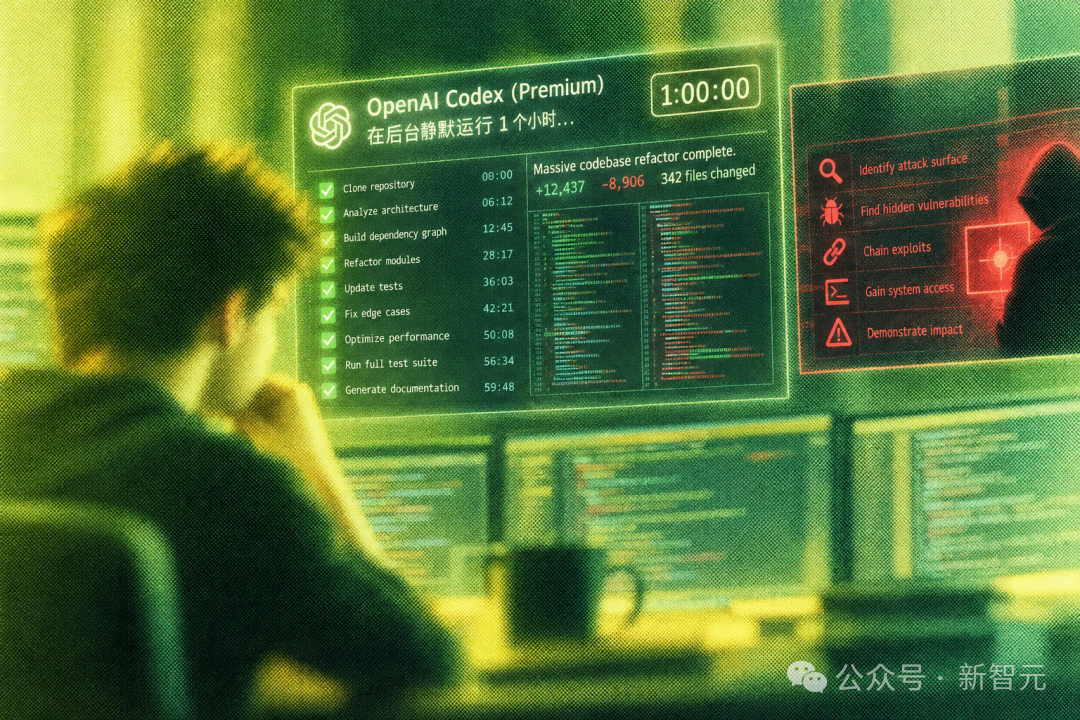
OpenAI最高端、付费版的Codex模型,可以自己在后台静默运行1个小时,然后完美重构一整套庞大的代码库,或者在复杂系统中精准发现并利用漏洞。
正如Karpathy所引用的大V发言:「你对AI感到敬畏的程度,与你使用AI写代码的频率完美正相关。」
这群专业人士,正在经历认知曲线垂直飙升的「眩晕时刻」。他们比任何人都清楚,AI能力的斜率多么恐怖,以及这背后的网络安全连锁反应。
两群人,已经完全处于「鸡同鸭讲」的状态。
第三重折叠:5000名内部人士眼中的「超级智能雏形」
如果说2000万人的「眩晕」已经足够震撼,那么漏斗最尖端的第四层,则超出了常人想象。
在金字塔顶尖,全球仅仅只有约5000人(占全球人口0.00006%)。
用珠穆朗玛峰打比方:全球有7500人登顶过珠峰,而真正见识过前沿AI极限能力的人,比登顶珠峰的人还要少。这个漏斗模型堪称「疯狂」。
这5000人是谁?是那些能接触到AI公司最核心内部前沿级系统的内部人士。
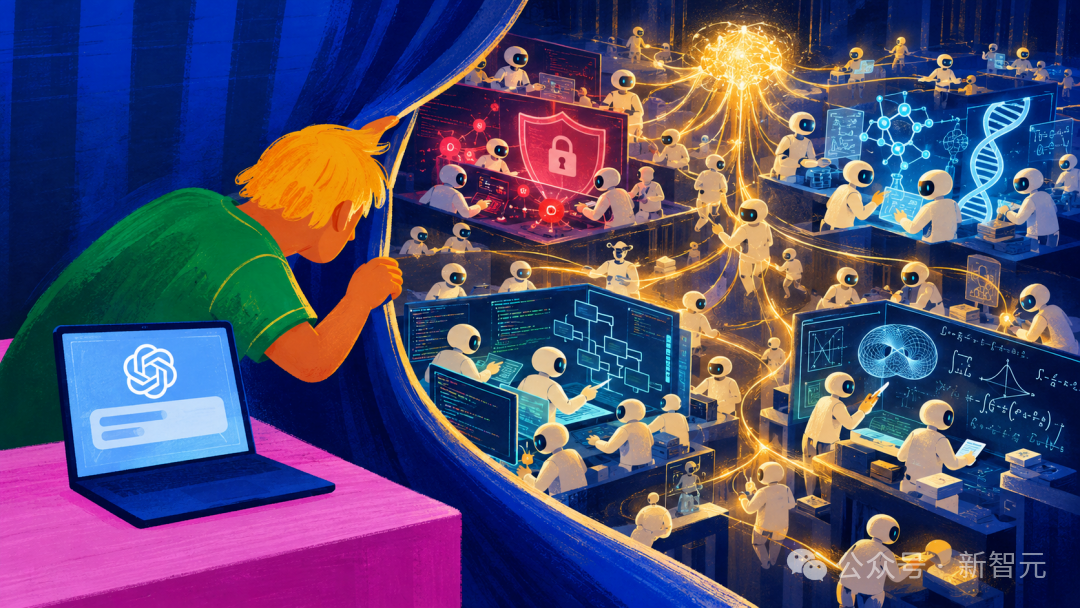
外部世界看到的,仅仅是AI能力的「预览版」。而这5000名内部人士亲眼目睹的,是真正的「智能体蜂群」。
在内部,成千上万个智能体正在像蜂群一样,在没有任何人类干预的情况下,自主协作长达数周,去攻克那些惊天动地的软件巨型项目。
他们在干什么?在发现零日漏洞、在进行网络攻防实战演练、在发现新科学,在推进数学前沿。
这些事情,原本需要顶级专家耗费数年心血才能完成。
最可怕的是:人类的审查与理解能力,已经开始落后于机器。
Karpathy举例说:机器生成内容的速度和深度,已经让内部人士疲于奔命。
比如,「OpenAI-Hugging Face事件」已经过去很久,但人类研究员至今仍在庞大的机器生成日志中「考古」;而对于AI生成的722篇数学手稿,顶尖数学家需要很长时间去消化,才能勉强消化AI的推演逻辑。
为什么会出现如此极端的「认知折叠」?
为什么会形成如此尖锐的漏斗?Karpathy指出三个核心因素。
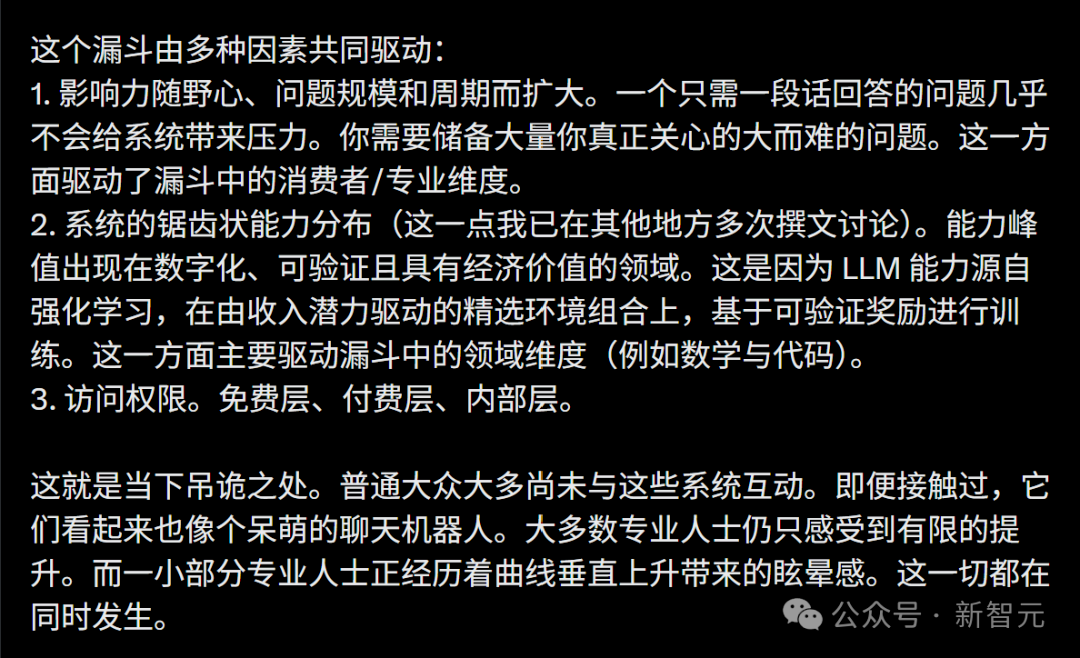
第一,影响力与你的「野心」、问题规模成正比。
如果你只让AI写个邮件、查个食谱,系统根本连热身都算不上,完全无法逼出它的极限。
你必须拥有一个充满困难问题的「蓄水池」,并且是你真正关心、亟待解决的难题,你才能感受到AI的恐怖。
第二,AI能力的「系统锯齿性」与可验证奖励。
为什么这种爆发式增长主要集中在数学和代码领域?因为当前AI能力的巅峰,出现在那些数字化、可验证且具有经济价值的领域。
这涉及到大模型底层机制的秘密:LLM的强大能力,来源于「强化学习」。在代码和数学中,对错绝对清晰。这种明确的「可验证奖励函数」,让AI能够进行高效的RL训练。
相比之下,让AI写一首诗或一篇文章,好坏的评判非常主观,很难进行明确的强化学习。
不仅如此,代码和数学等B2B场景具有极高的商业价值。由于利润丰厚,各大科技公司最精锐的团队和最多的资源都集中在这些领域。
第三,访问权限的鸿沟。
免费版、付费版和内部权限。这三道阶梯,物理上隔离了全人类对AI的认知。
我们正处在人类历史上一个诡异时刻。
在这个时空的同一秒钟里,大众看见的AI,与前沿内部的真正实力,早就不在一个纪元。
请记住Karpathy的警告:你以为愚蠢的AI面具背后,一个超级智能雏形,已经在极其少数人的注视下,悄然苏醒。