DeepSeek开源推理框架,将大模型行业的讨论从模型能力进一步引向推理成本。
10月20日,DeepSeek宣布开源内部推理框架DeepInfer,以及用于Token编解码的deepseek-recipe。DeepSeek表示,DeepInfer服务于DeepSeek V4.1-Flash的大规模推理,目标是在降低延迟的同时提高吞吐量。框架支持英伟达GPU和华为昇腾NPU,采用Apache-2.0开源许可证。
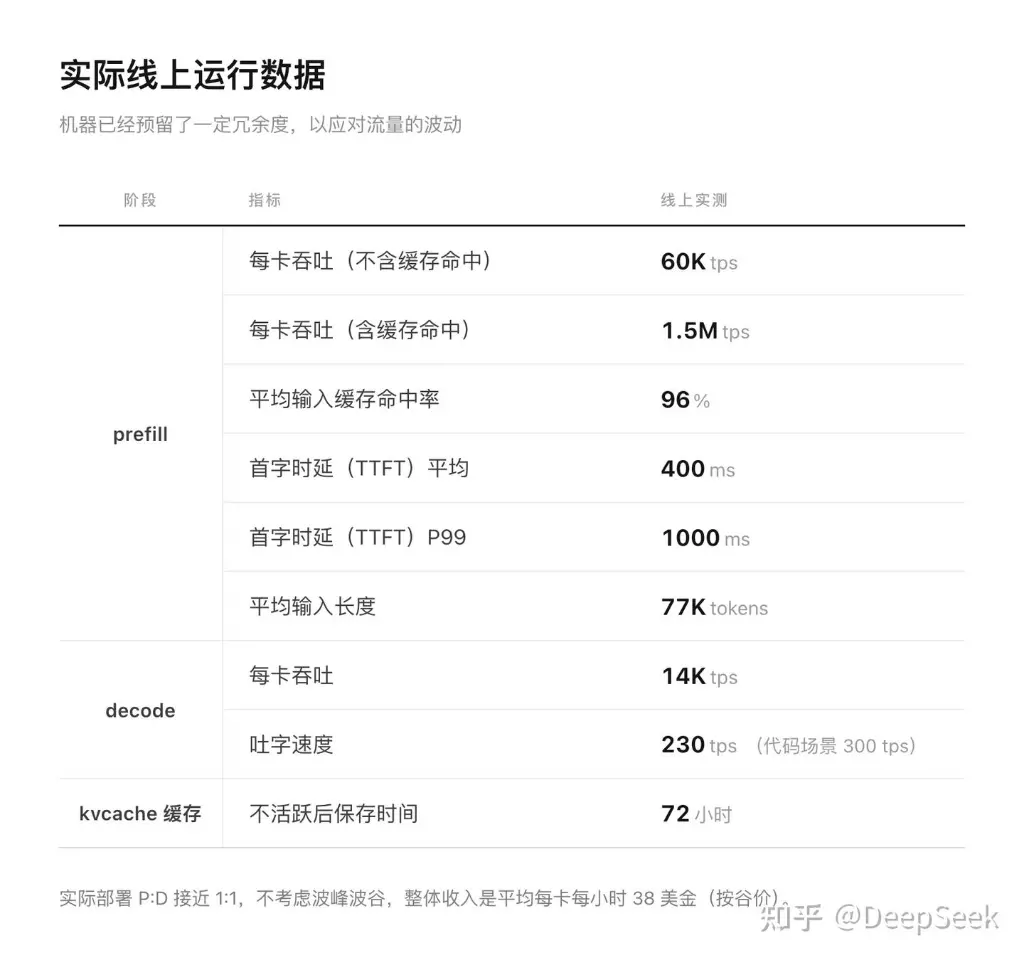
此次开源引发关注的一个背景,是DeepSeek披露的推理服务收入。根据DeepSeek在GitHub发布的部署问答,V4.1-Flash单集群每天处理155万亿Token,按谷电时段价格计算,整体收入达到每GPU小时38美元。
社媒据缓存率、吞吐和定价等假设,估算其推理毛利率最高可能高达84.2%—96.1%。分析人士推演指出OpenAI与Anthropic主流模型的API毛利率同样或达95%。
这项披露给外界提供了观察推理经济账的一个切口。不过,收入数字本身并不能说明利润水平。要判断每小时38美元收入对应多少毛利,还需要知道硬件折旧、能源、网络、缓存存储和运维等成本。
海外科技投资研究员Zephyr在社交平台X上发表测算指出,DeepSeek实际上“公开了其商业模式背后的核心秘方”。他估算,DeepSeek推理毛利率可能达到84.2%—96.1%,修正了早期给出的87.76%—96.94%区间。
他设定了一个典型的基础模型:假设在实际生产中,97% 的输入命中键值缓存,未命中缓存的输入占 2%,输出占 1%。
缓存输入(Cached Input): 占总 Token 量的 97%(单价极低,计算负载极轻);
未缓存输入(Uncached Input/Prefill): 占总 Token 量的 2%;
生成输出(Output/Decode): 占总 Token 量的 1%。
在此流量结构下,Zephyr 结合官方公布的单卡极限吞吐量(预填充每秒 8 万 Token、解码每秒 1.6 万 Token)测算产值。根据其模型,一张 GPU 满载运行时,理论上每小时可处理对应的 Token 组合并产生最高约 49 美元的账面收入。
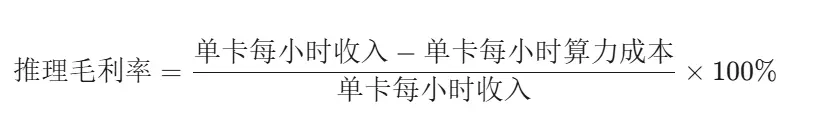
若按照当前海外公有云市场中,一张顶规 GPU(如英伟达 H100 或类似下一代硬件)普遍为每小时 1.5 至 4 美元的综合租赁成本计算,其硬件层面的推理毛利率公式为:
在极限测试工况下(每小时产出 49 美元,算力成本取 1.5 至 6 美元区间):
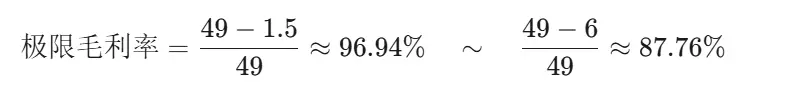
Zephyr表示在特定理想负载下,该框架对应的推理业务毛利率(Inference Gross Margin)处于 87.76% 至 96.94% 之间。他在推文中直言:“英伟达、SGLang 和 vLLM 的公开表现直接被碾压了。”
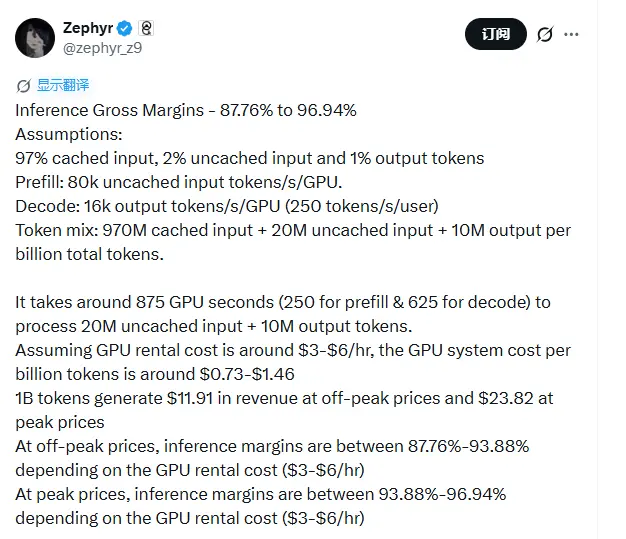
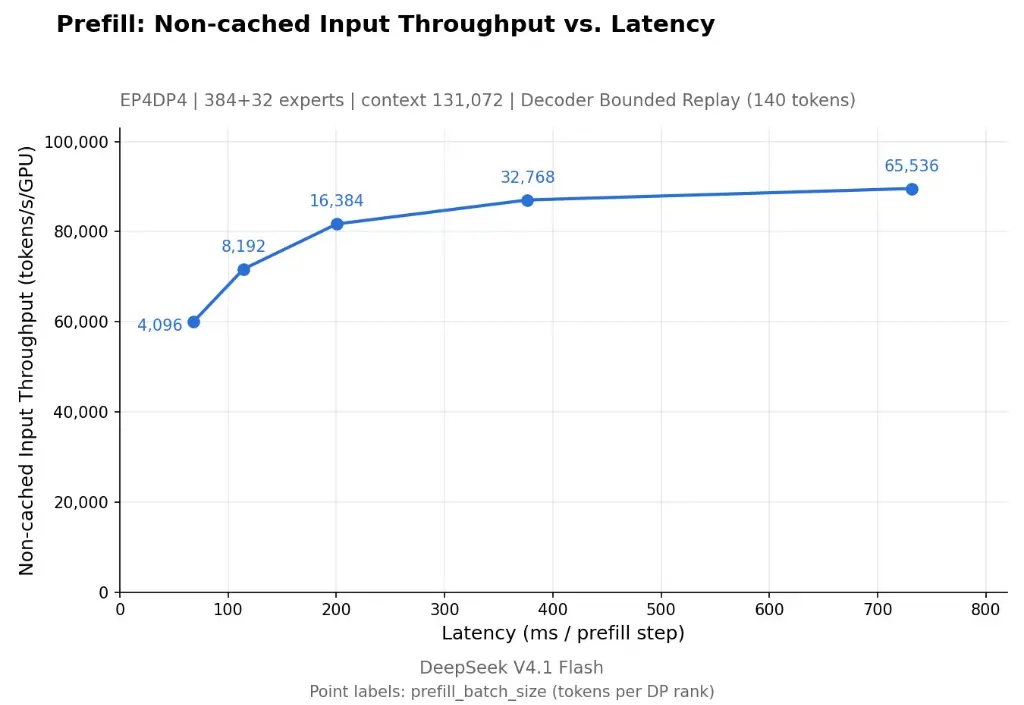
随后,Zephyr 根据 DeepSeek 官方披露的真实运营细节修正了测算参数。他补充写道:“这些极端毛利基于理想场景,彼时服务商每小时可产出约 49 美元。DeepSeek 官方公布其非高峰期每卡每小时实际创收约为 38 美元,且生产环境能达到基准测试约 80% 的性能。基于这些最新数字重新评估,实际运行毛利率落在 84.2% 到 96.1% 之间。”
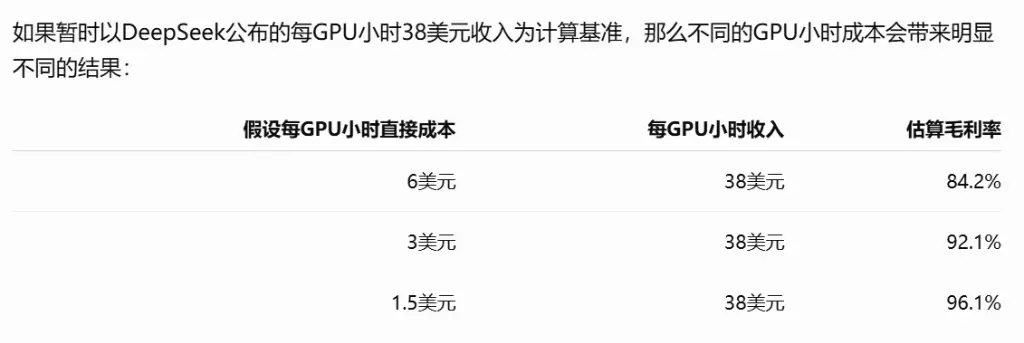
目前海外云服务市场中,租赁单张顶级 GPU 的综合成本普遍在每小时 2 至 4 美元区间。38 美元的单卡时产值与单位算力成本之间形成的巨大剪刀差,正是推高毛利率测算的核心依据。
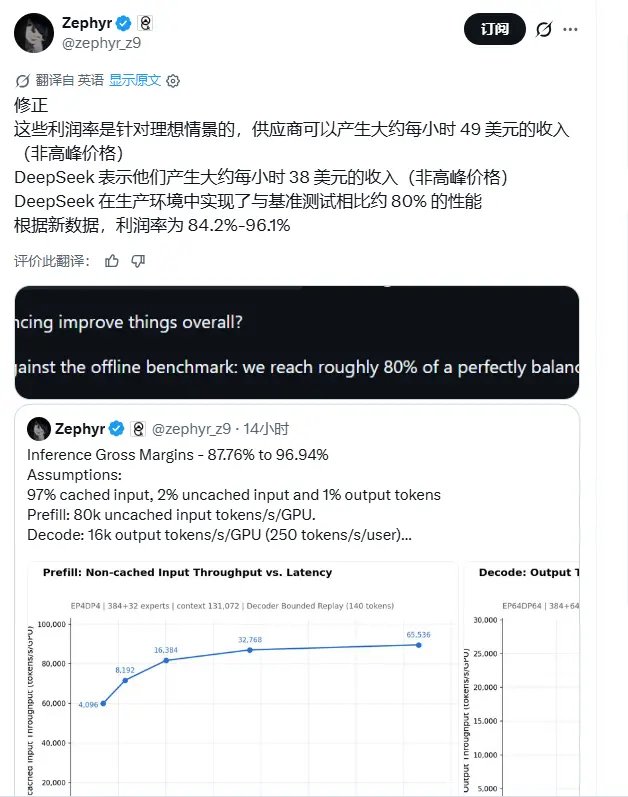
该测算发布后,迅速在行业内引发了关于头部 AI 实验室真实盈利能力的连锁讨论。
科技投资观察人士 Alex Corrino 在转发上述测算时发问:“如果我告诉你们,所有顶级 AI 实验室的 API 毛利率其实很可能都在 80% 以上呢?”
Zephyr 随即引用该推文并给出了更为激进的判断:“对 Anthropic 和 OpenAI 而言,这个数字实际上是 95%(适用于 Sol、Fable、Sonnet、Astra 等主流主力模型)。”
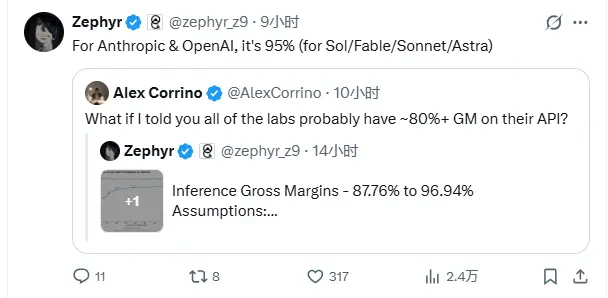
在全行业普遍具备高毛利的前提假设下,投资分析人士 Scott 进一步将该逻辑平移至终端用户的“订阅制(Subscription)”经济模型,推演海外头部的真实底牌。
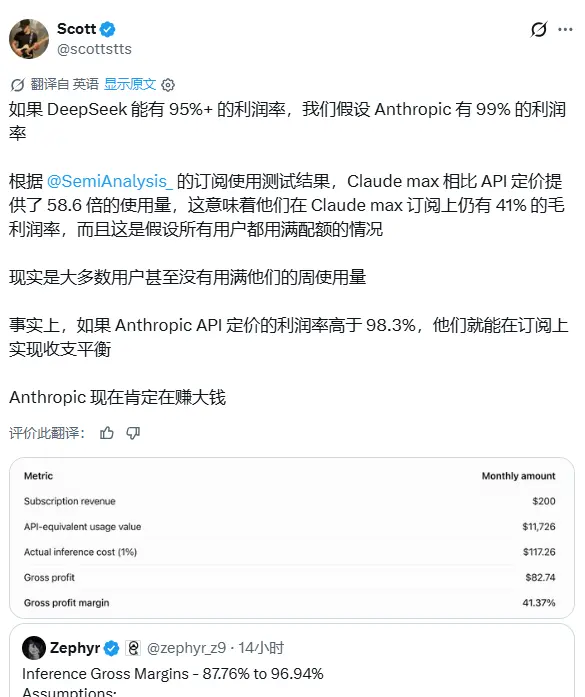
根据研究机构 SemiAnalysis 的实测报告,Anthropic 为其高级会员“Claude Max”提供的实际可用 Token 额度上限,达到了其对应官方 API 单价货值的 58.6 倍。外界据此一度认为,高用量订阅用户会严重吞噬平台利润导致倒贴。
Scott 给出了反向推导公式:
设定基准前提:假设 Anthropic 的 API 硬件毛利率同样高达 99%(成本率仅为 1%)。
订阅制用量极端打满时的成本反推:用户支付 1 单位订阅费,若彻底消耗完等价于 58.6 单位 API 标价的算力额度,对应 Anthropic 承担的实际底层硬件成本为:
实际硬件成本=58.6×1%=0.586 单位实际硬件成本=58.6×1%=0.586 单位
推导极端状态下的订阅毛利率:
Claude Max 极端毛利率=1−0.5861=41.4%Claude Max 极端毛利率=11−0.586=41.4%
Scott 由此分析称:
“如果 DeepSeek 的毛利率能达到 95% 以上,假设 Anthropic 的 API 毛利率为 99%。基于 SemiAnalysis 的测试,Claude Max 提供了高达 API 标价 58.6 倍的使用额度。这意味着,即便所有用户都把配额彻底打满,Anthropic 在订阅模式下仍能保留约 41% 的毛利率。 而现实中绝大多数用户根本不会用满每周上限。”
他指出:“实际上,只要 Anthropic 的 API 利润率维持在 98.3% 以上,即使用户全量打满限额,其订阅业务也能实现收支平衡。Anthropic 当前绝对处于稳健的盈利状态中。”
科技分析账号 Teortaxes 同样评价称:“在主力实验室的内部自研架构面前,市面上所有的公开基准测试都不值一提。这就是严肃做工程能换来的成果,推理业务本身就是一台印钞机。你可以想象 Dario(Anthropic 首席执行官)此刻该有多焦虑。”
随着真实的推理成本结构浮现,业内也重新审视了不同的技术降本路线。
在硬件架构与单位吞吐成本上,业内将该方案与主打超低延迟的芯片厂商 Groq 进行了对照。
行业观察人士指出,以 Groq 为代表的 LPU 定制硬件架构依赖板载 SRAM,换取了极致的交互生成速度,但其芯片显存容量极小,承载主流大模型需要成倍堆叠硬件板卡与庞大的节点互联,导致单 Token 的整体硬件折旧与采购门槛居高不下。
相比之下,DeepInfer 则展示了通用芯片路径的另一种账本逻辑:在通用 GPU 及昇腾等商用 NPU 上,单纯通过软件调度极致榨取并发吞吐量,以更低的综合硬件成本换取规模化 API 服务的利润空间。
不过,多位产业观察人士在讨论中指出,上述 80% 至 95% 的毛利测算主要聚焦于“Token 售价与单卡硬件消耗”之间的直接账面差额。这种微观测算并没有计入前期基础模型数以亿美元计的研发训练支出(R&D)、全球节点的高速带宽网络成本,以及高昂的系统工程团队薪资。
接下来需要验证的,是开源实现能否在不同硬件和实际业务负载下稳定提高吞吐、降低每个有效输出Token的成本。对于DeepSeek自身,外界同样需要更多成本与资源利用率数据,才能判断社媒估算的高毛利是否接近真实经营水平。