

这两天彻底爆火的 Jev,是一个完全不会聊天、不会写代码,却能把很多 AI 决策成本降低 400 倍的全新模型。
但是很多人对 Jev 还是云里雾里,
我详细研究了一下,希望这篇文章能够让你一文彻底搞懂 jev,正好今天 jev 全员可用了,可以去实操一下
不想看文字版的,我用 GLM-5.3 flash 做了一个 5 分钟的讲解视频,效果还挺好的,直接看视频就行
废话不多说,正文开始。
jev 没有任何文本生成能力。
但发布至今,它引发的讨论热度几乎是 ChatGPT 以来最高的一次。
过去两年,大家习惯了把所有需求都丢给通用大模型。
但现实业务里,软件系统每天面对的大量请求,根本不需要写一篇洋洋洒洒的长文。
系统真正需要的,往往只是一个个极小的确定性判断:
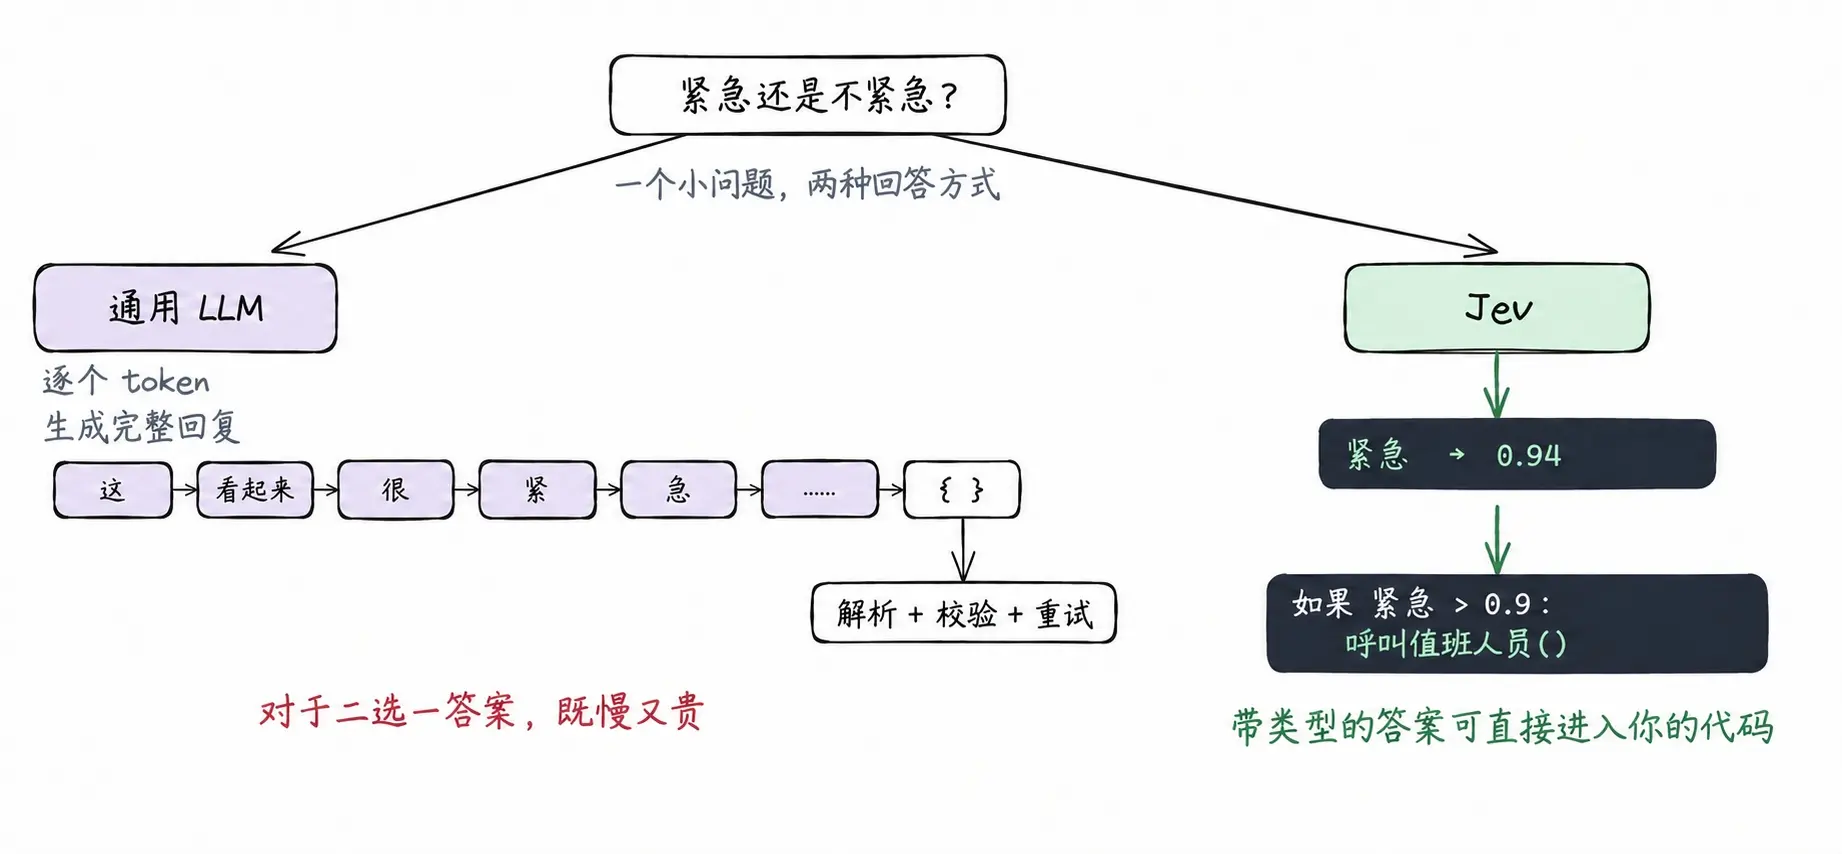
这封工单紧不紧急?
这个指令该分发给哪个下游模型?
用户输入的终端命令有没有删库风险?
刚刚检索出的这段知识到底能不能回答用户的问题?
以前做这些判断,开发者必须让大模型逐字生成回答,再用代码去解析 JSON,遇到格式报错还得重试。
这不仅速度慢,而且费用昂贵。
TypeSafe AI 推出的 Jev,就是专门为了解决这批决策需求而设计的。
他们把 Jev 称为“系统一(System One)模型”:输入一段非结构化数据,直接输出强类型的选项和精准的置信概率。
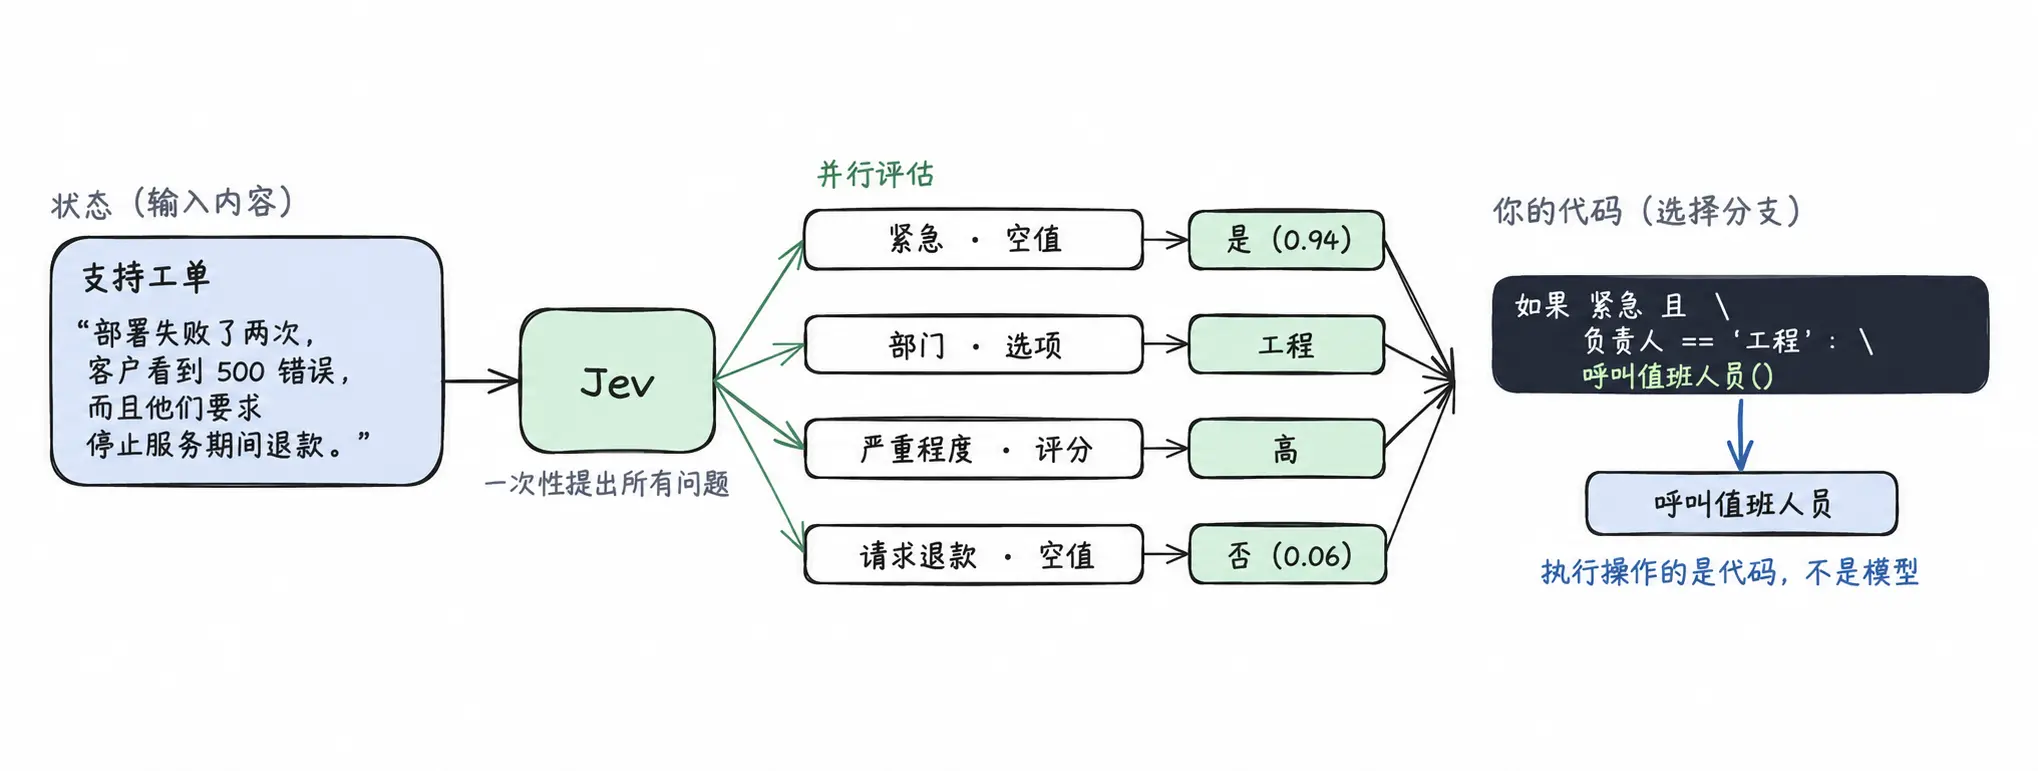
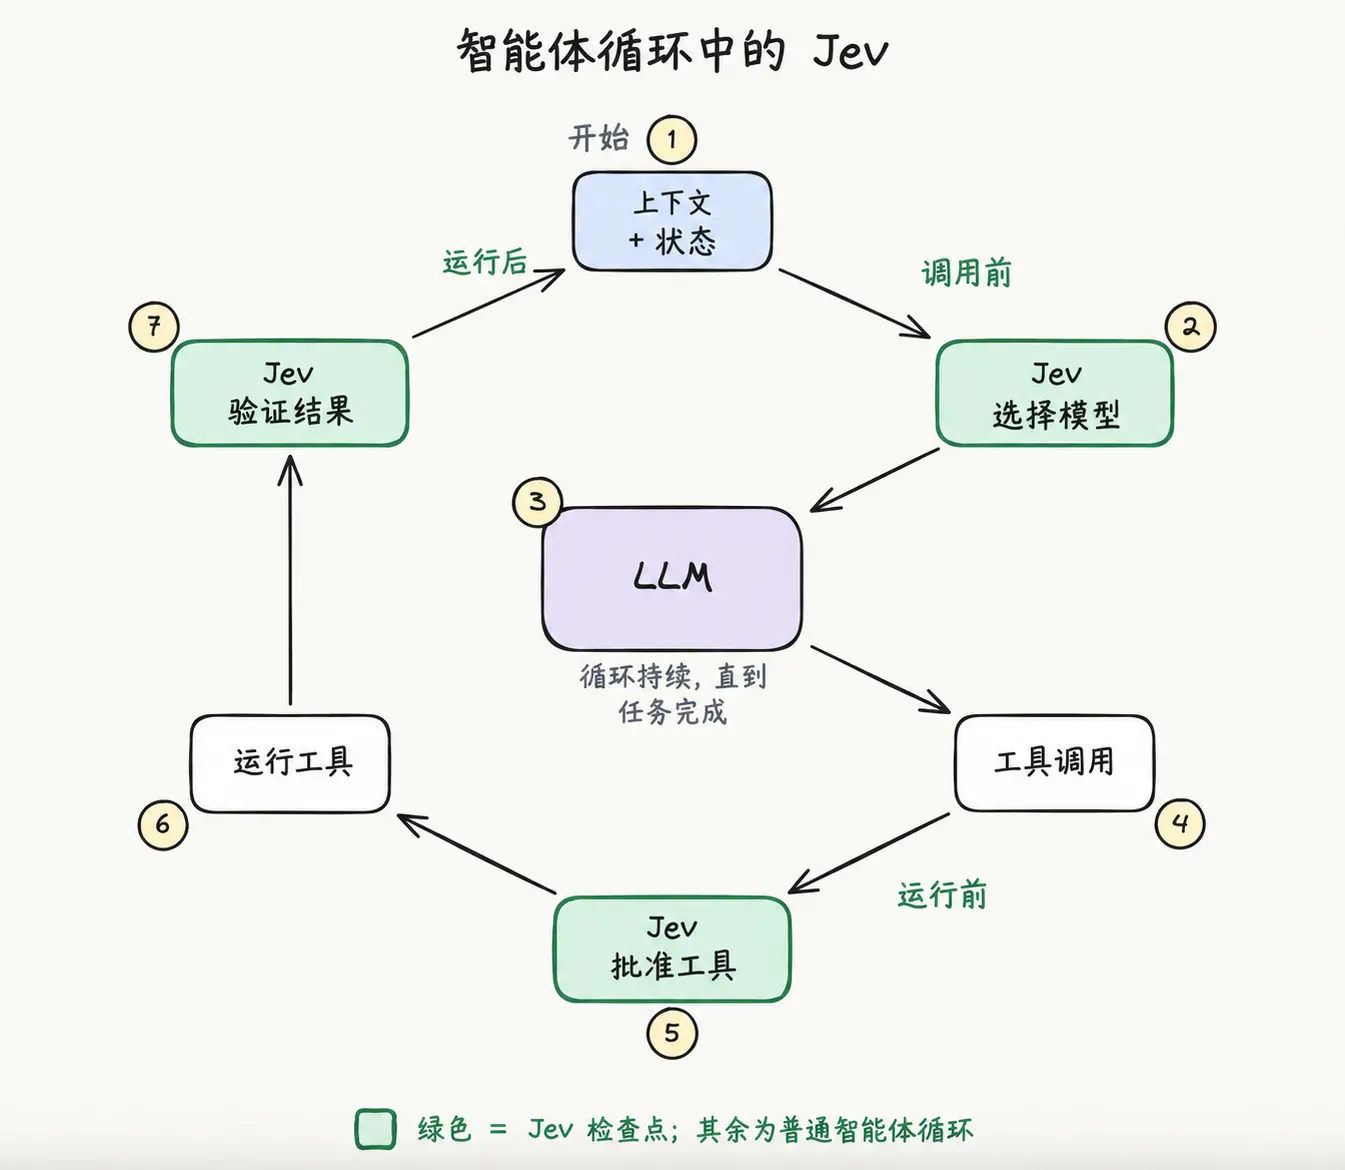
在典型的 Agent(智能体)循环里,系统每走一步都要做决策:
在这个循环中,模型要选工具、要检查执行结果、要判断有没有风险、要决定任务是否完成。
哪怕最终的决策只有一个单词,比如“finance”,传统生成式模型也是一个 Token 一个 Token 地往外吐。
你既要为输入付钱,也要为生成等待。
Jev 的核心逻辑非常直接:
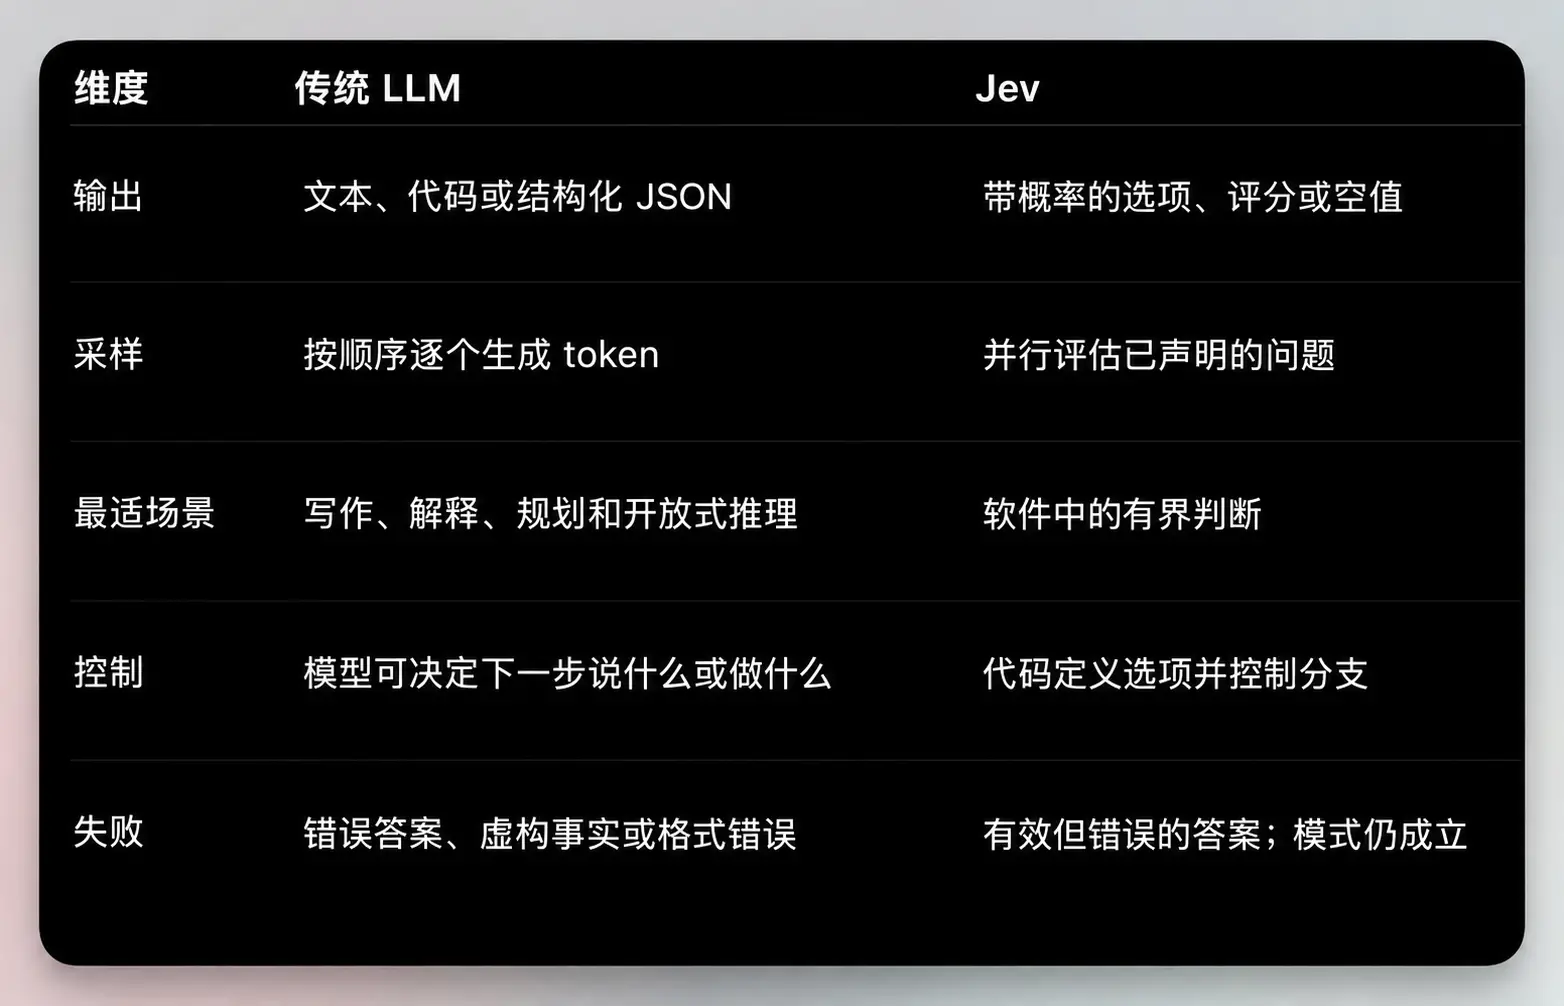
Jev 的本质是一个语义决策引擎。
调用 Jev 时,你只需要给它两样东西:
每个问题在提交前就必须固定输出类型。Jev 原生支持三种基础数据类型:
一个典型的请求长这样:
Jev 返回的不是一段解释,而是一个确定的概率值和一个团队概率分布。
没有任何多余废话,它也不会凭空编造出第四个不存在的团队。
业务代码直接接管逻辑控制:
很多工程师把它形容成“带语义理解能力的 switch 语句”。
业务分支仍然牢牢掌握在传统代码手中,Jev 只负责提供代码本身算不出来的语义判断。
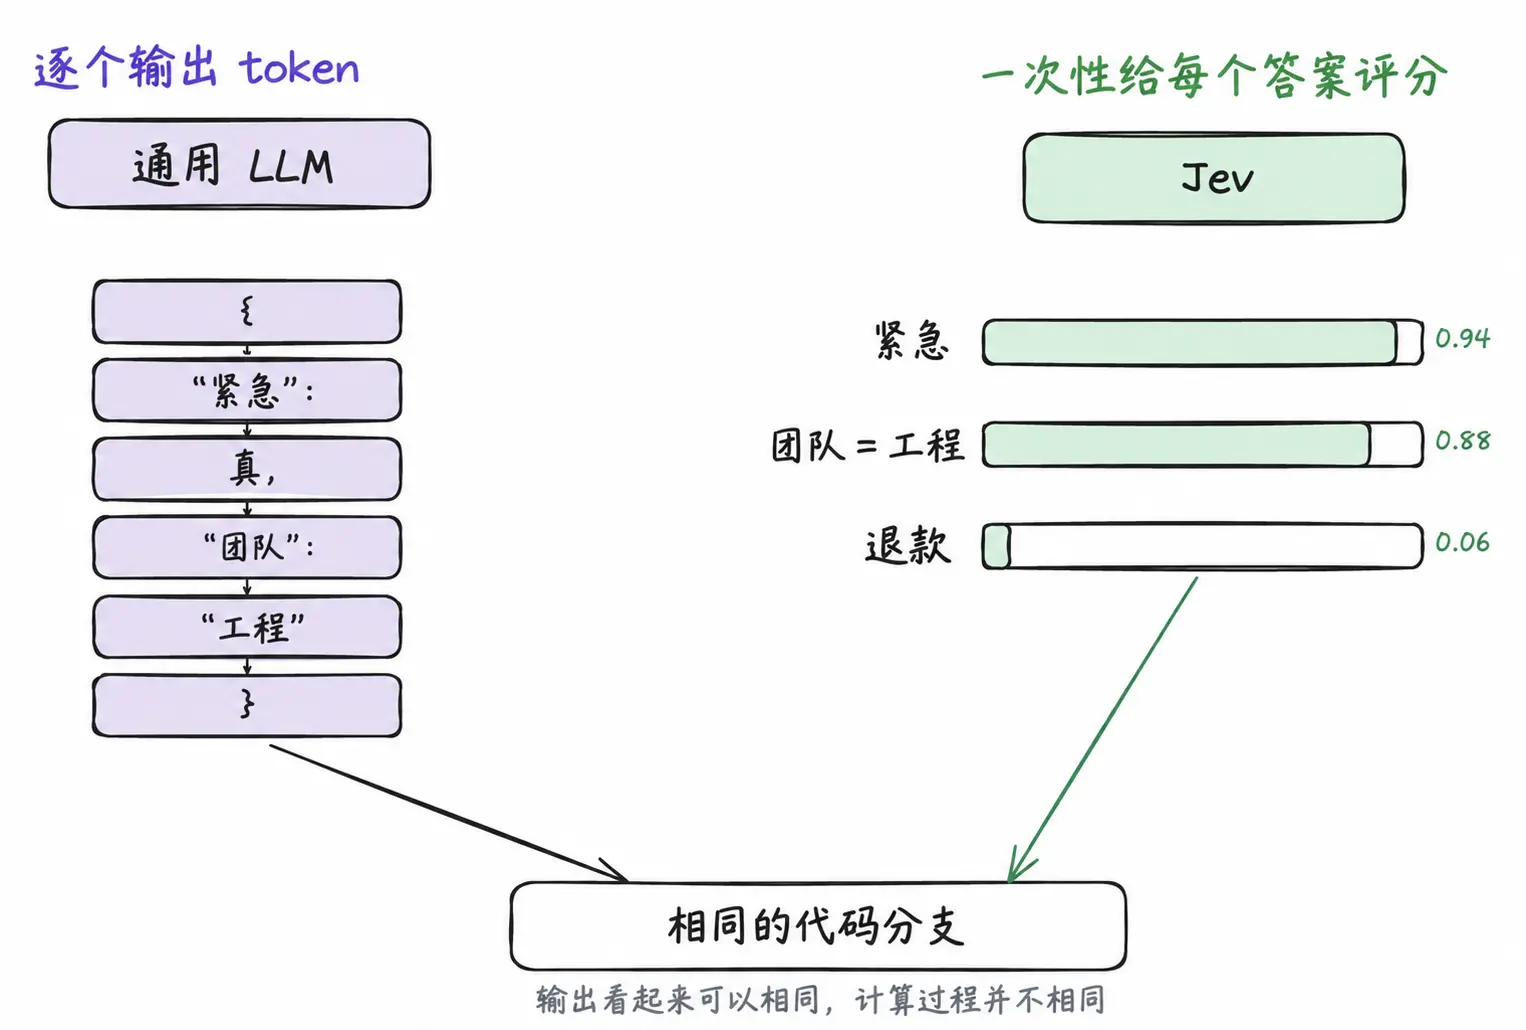
Jev 支持在单次请求中并行评估所有问题。
这意味着你不必串行提问,可以把针对同一段内容的所有独立判断一次性发过去。
官方公布的实测数据:
在官方给出的多项工作流实测对比中,它的综合执行速度大约是传统大模型工作流的 200 倍,综合成本降低了接近 400 倍。
即便在复杂业务环境下把这些数据当成理论上限来看,它所带来的效率提升也是数量级维度的。
只给一个分类标签,往往不够安全。
假设 Jev 判定一个工单属于“财务团队”,返回结果如下:
财务获得了最高票,但技术支持拿到了 46% 的概率,整体置信度只有 0.18。
如果系统直接自动分配,极易出错。
有了这层概率分布,开发者就可以在代码里明确划线:
Jev 采用了“基于校准决策的强化学习(RLCD)”训练方法。当模型给出 90% 的概率判定时,其真实准确率也能高度收敛在 90% 左右。
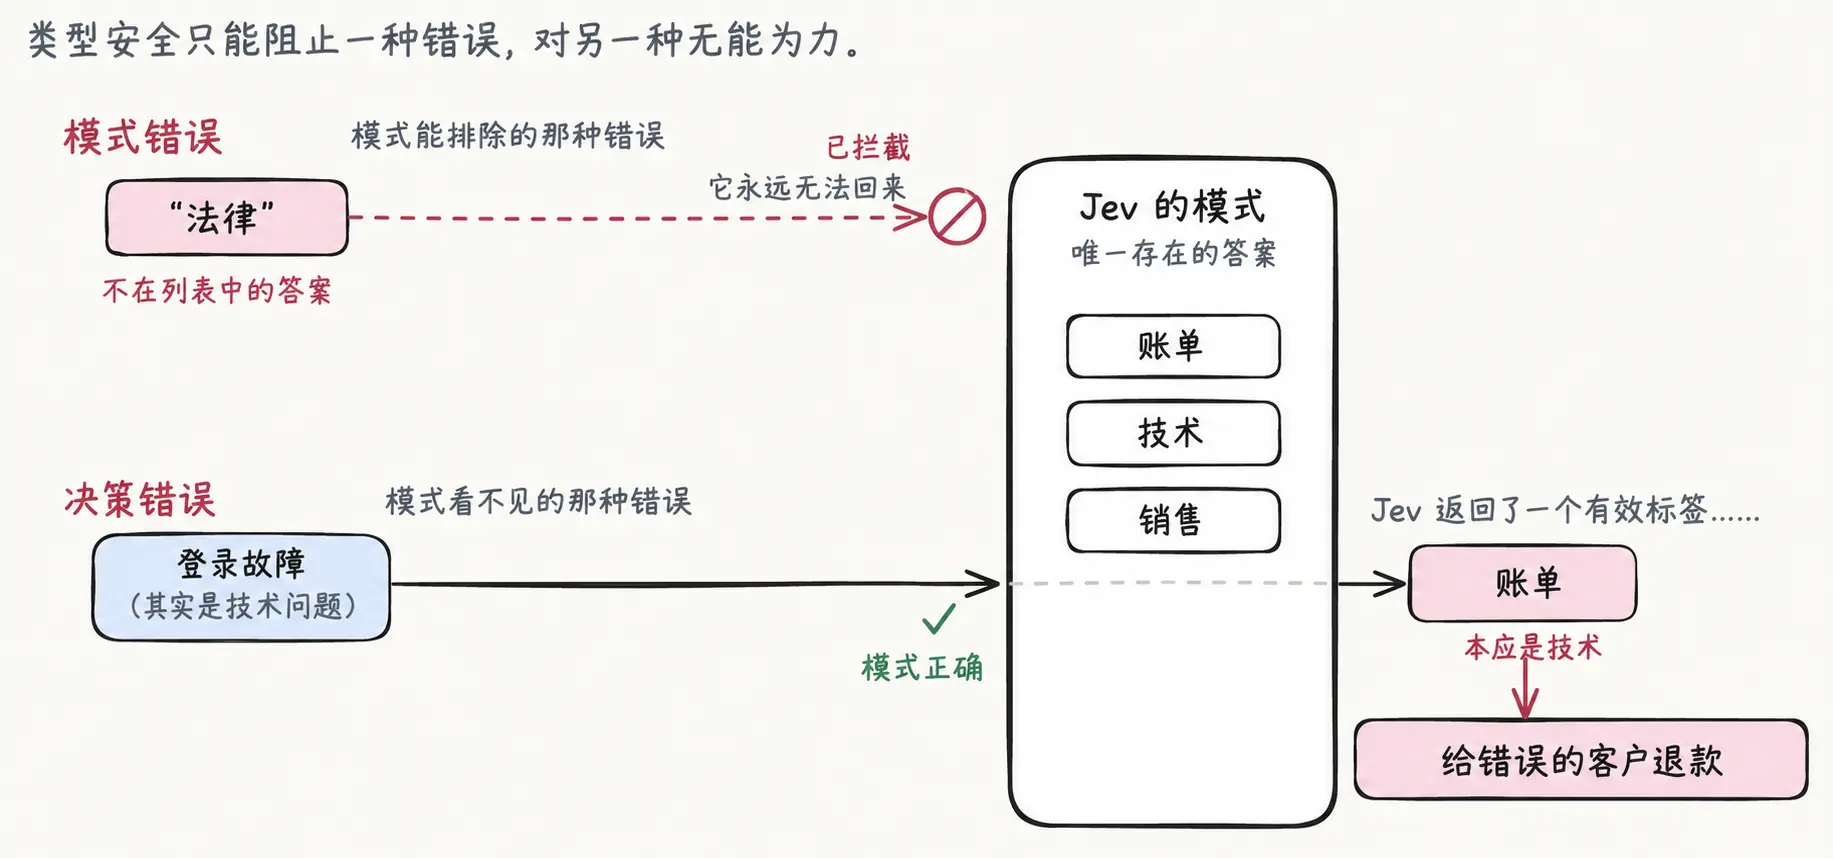
官方宣传中提到“Jev 不会产生幻觉”。这个说法成立的前提非常严格。
Jev 绝不会跳出你给定的 Schema 返回格式之外的内容。如果你定义了 A、B、C 三个选项,它绝对不会返回 D,更不会输出乱码 JSON。
但这绝不代表它的判断永远正确。
类型安全保证的是输出结构不崩溃,并不保证业务判断不出错。
一个符合类型定义的错误判断,依然可能错误地退款、错误地分发故障工单。
准确的理解应该是: Jev 保证不会破坏代码契约,但它依然有概率选错选项。
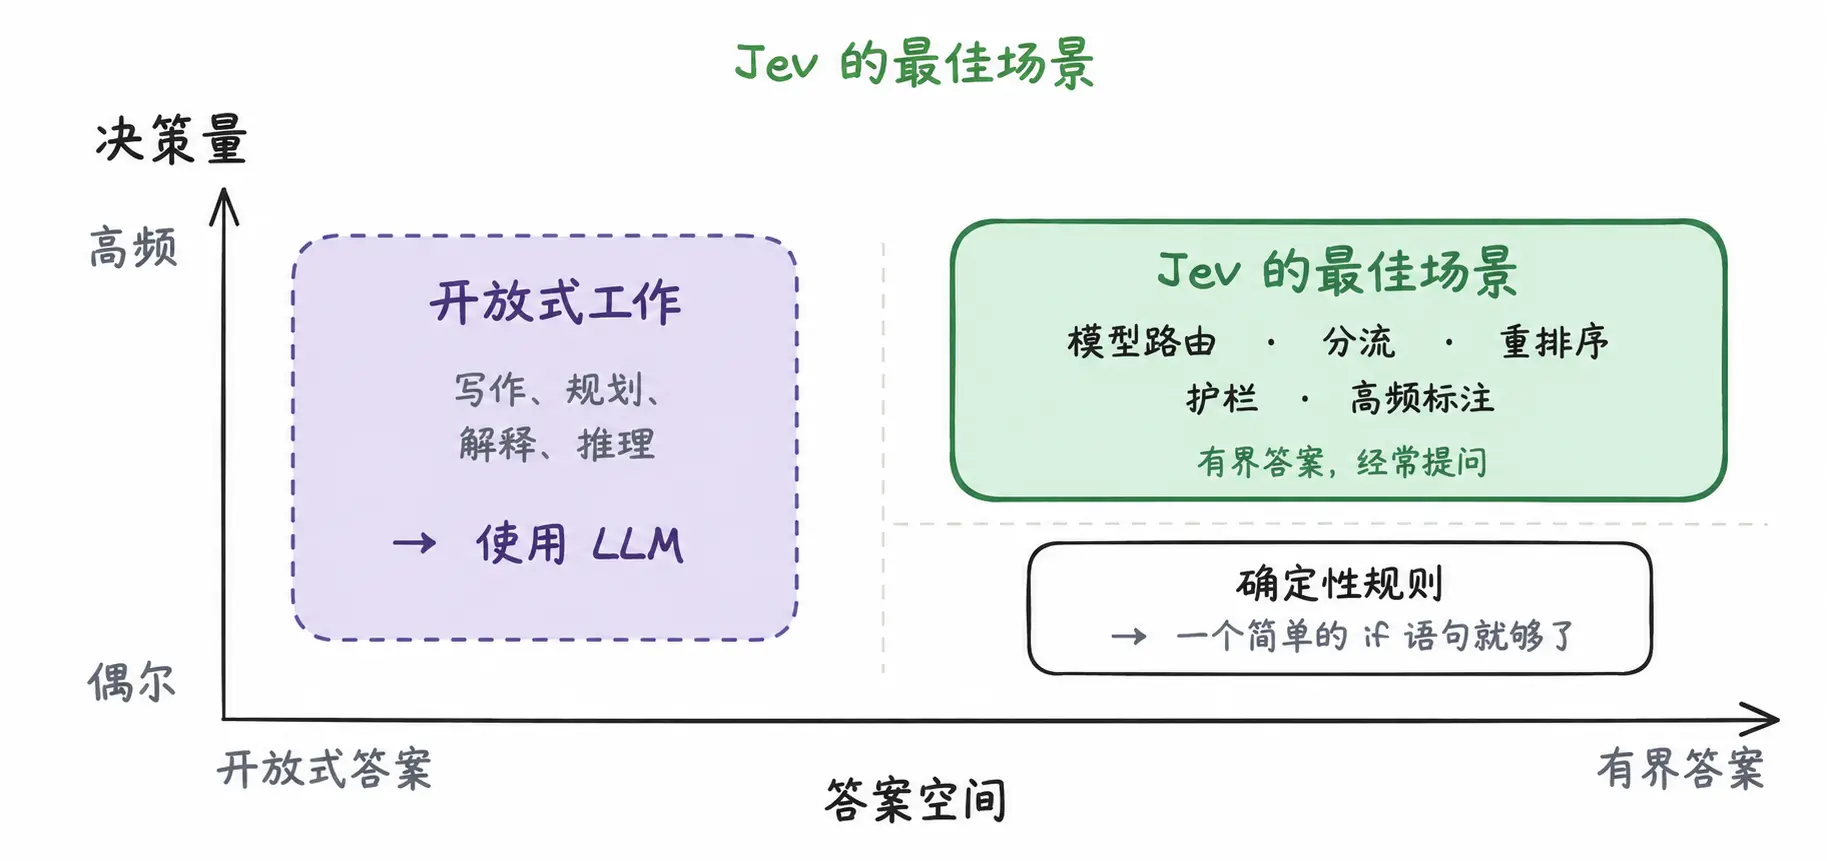
Jev 的定位非常清晰:它设计出来是配合大模型,不打算取代大模型。
大模型负责写代码、写方案、做长文本推理与沟通。
Jev 负责围绕在它周围,做高频、快速的边界控制。
目前最成熟的落地场景有三个:
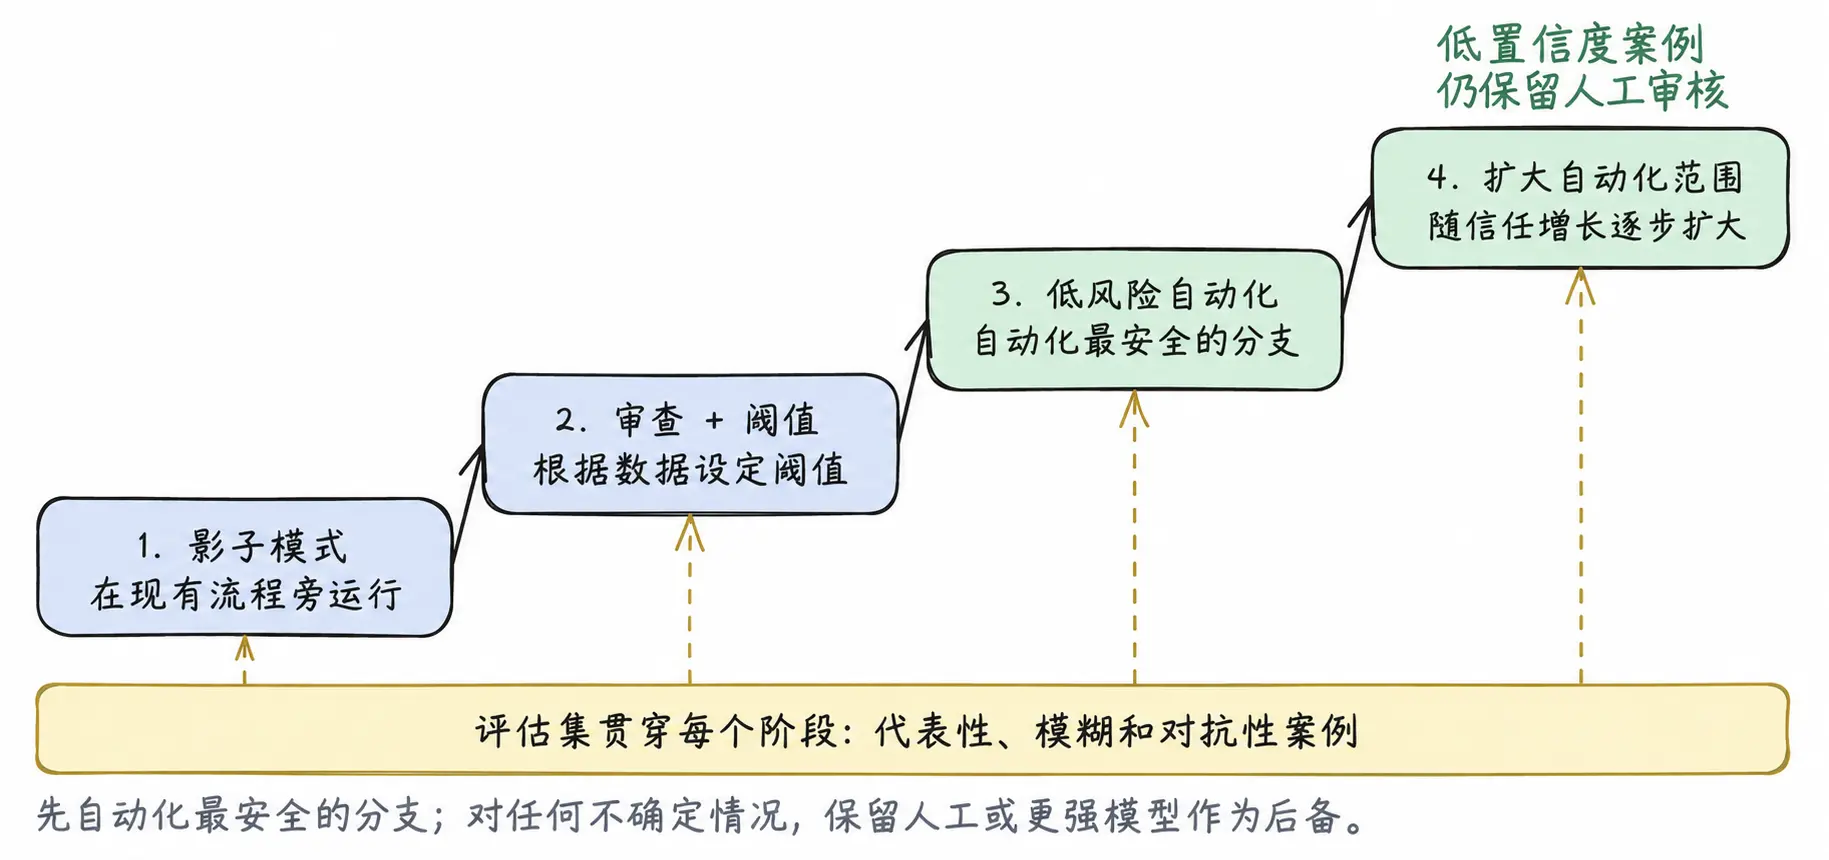
任何不需要它的地方,都不要强行引入:
不要一上来就重构核心业务。
最稳妥的接入方式是:
目前 TypeSafe 已经完全放开访问,无需等待名单。注册赠送 5 美金额度,相当于可以直接测试约 1.2 亿个 Token 的输入量。
整个行业在过去几年里,习惯了用文字生成去解决一切问题。
但在很多工程系统里,代码需要的往往不是更多优美的文字,而是一个毫秒级响应、不破坏格式、成本极低的准确判断。
这也是 Jev 能够迅速引爆开发者圈子的根本原因。